สวัสดีครับเหล่าสาวกชานม
ก่อนอื่นเลยผมจบ AI Engineer ก็จริงแต่ผมยังเป็นมือใหม่ของ LLM Inference มากๆ โพสต์นี้ผมจะไม่ลงลึกใด ๆ ทั้งสิ้นเพราะผมเองก็มือใหม่ (ไม่ต้องพูดถึง LLM Gateway หรือ LM Cache เลย) ฮา! ส่วนที่มาของโพสต์ผมแค่ตื่นเต้นที่ได้ลองแงะเล่นเจ้านี้เฉย ๆ 😅
ด้วยโอกาสอันดีนี้จึงมีโอกาสได้ลองเจ้า ASUS Pro ET900N G3 (NVIDIA® GB300 Grace Blackwell) แน่นอนว่ามันค่อนข้าง Crazy! เลยหล่ะครับกับ Specs ที่ได้มา
รายละเอียด
- GPU: NVIDIA® GB300 Grace Blackwell 20 PFLOPS
- VRAM: ~ 252 GB
- CPU: ARM Neoverse-V2 72 Cores 1 Thread per Core up to 3.366 GHz
- System RAM: ~ 496 GB
- Coherent Pool: ~ 748 GB of Coherent Memory
- Storage: M.2 2280 NVMe PCIe 5.0 SSD, total 8TB
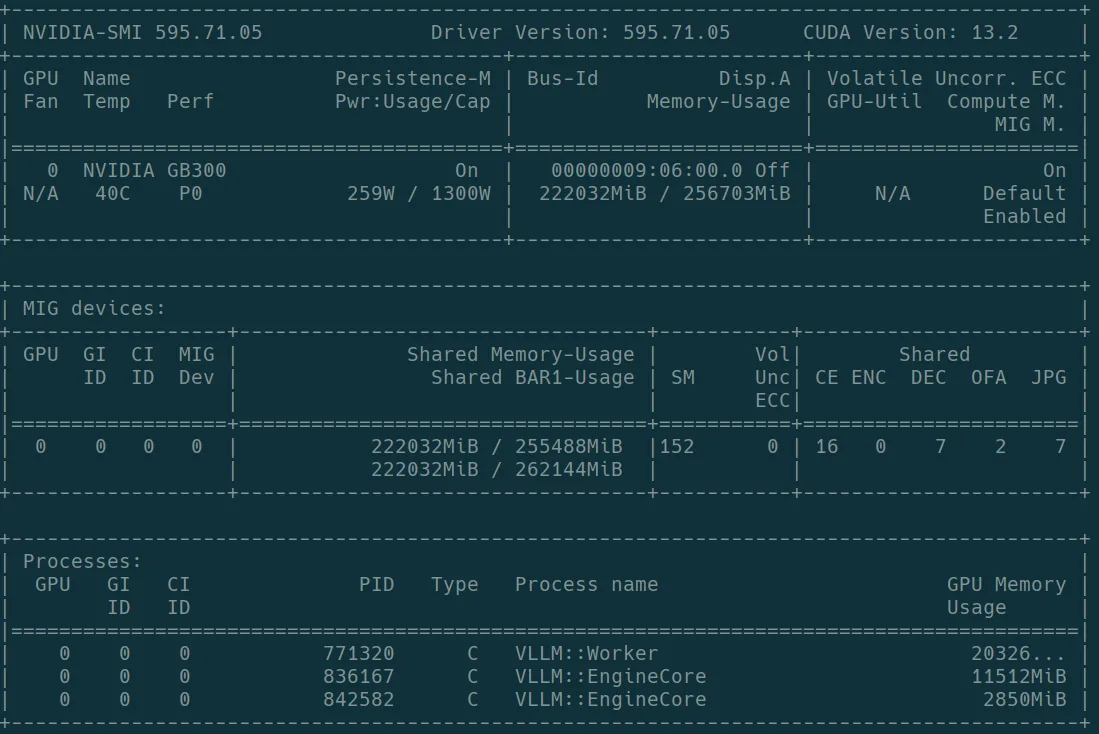
ที่เห็นใช้ไป ~220 GB นั้นคือการ Run Container ของ Qwen3.8-Flash-Next-NVFP4, TyphoonOCR, BGE-M3 ที่พยายามใช้ VRAM เพื่อจองพื้นที่สำหรับ Weight Model และ KV-Cache (รวมถึง MIG)
ลงมือทำกัน
โดยในส่วนนี้จำเป็นต้องเตรียมของไม่กี่อย่าง เพื่อที่เราจำเริ่มต้นทดสอบ Run Dock Container โดยทำการโหลด Docker Image ที่เป็น Weight Model ของ QWEN มาจาก Hugging Face ที่สำคัญมันเป็น Model Open Source ครับ หมายความว่ามันฟรี !!
สิ่งที่ต้องมีก็คือ
- ASUS Expert Center Pro ET900N G3
- Docker
- Hugging Face Account (HF_KEY ยืนยันตัวตนเพื่อให้โหลดไวขึ้น)
วิธีดำเนินการ
- ตรวจสอบ Docker
ตรวจสอบว่าในเครื่อง Host หรือ ASUS Expert Center Pro ET900N G3 ได้ลง Docker ไว้ในเครื่องรึยัง
$ docker --version
# ควรจะได้ผลลัพธ์หน้าตาประมาณนี้ Docker version 29.1.3, build 29.1.3-0ubuntu3~24.04.1
- เลือก Model และตั้งค่าเบื้องต้น
เข้าไปยังเว็บ https://recipes.vllm.ai/Qwen/Qwen3.8-Flash-Next แล้วเลือการตั้งค่าที่เหมาะสมกับเครื่องเราให้ได้มากที่สุด โดยเบื้องต้นผมจะกำหนดดังนี้ครับ
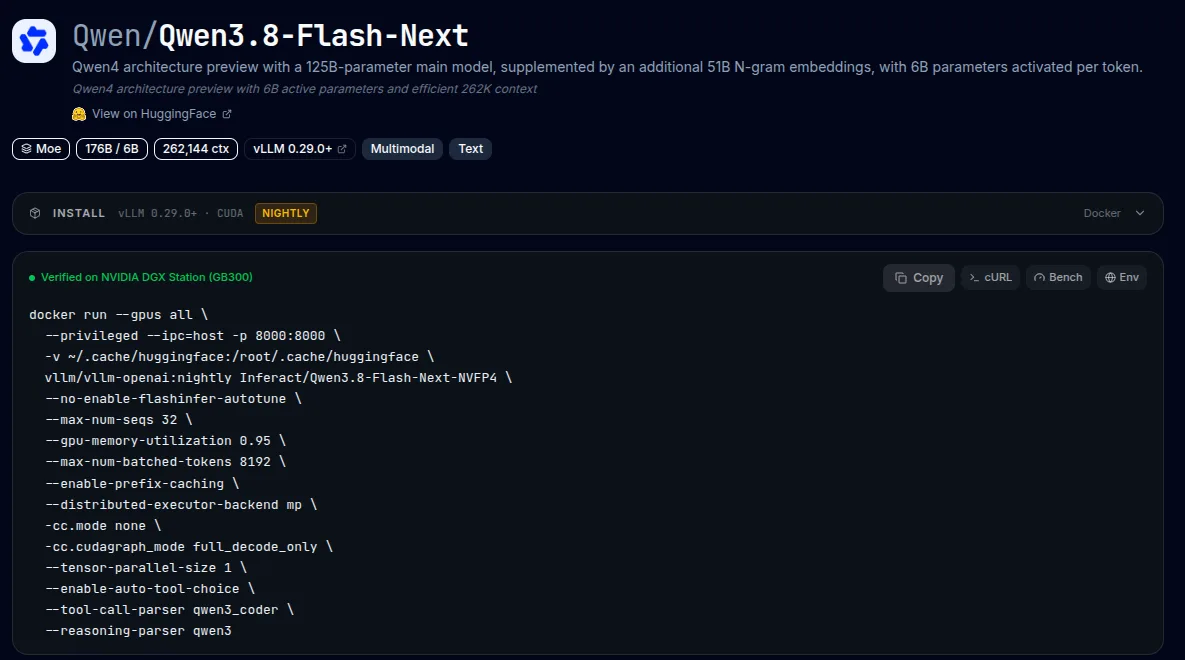
# 2.1 ขั้นตอนนี้เป็นการ Run Docker Container ที่ทำการโหลด Weight Model มาจาก Hungging Face ซึ่งใช้เวลานานพอสมควร

$ docker run -d --name vllm-qwen-flash-nvfp4 \
  --gpus all \
  --privileged --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:nightly Inferact/Qwen3.8-Flash-Next-NVFP4 \
  --no-enable-flashinfer-autotune \
  --max-num-seqs 32 \
  --gpu-memory-utilization 0.95 \
  --max-num-batched-tokens 8192 \
  --enable-prefix-caching \
  --distributed-executor-backend mp \
  -cc.mode none \
  -cc.cudagraph_mode full_decode_only \
  --tensor-parallel-size 1 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder \
  --reasoning-parser qwen3
# 2.2 ดู Logs 30 บรรทัดล่าสุด

$ docker logs -f --tail 30 vllm-qwen-nvfp4
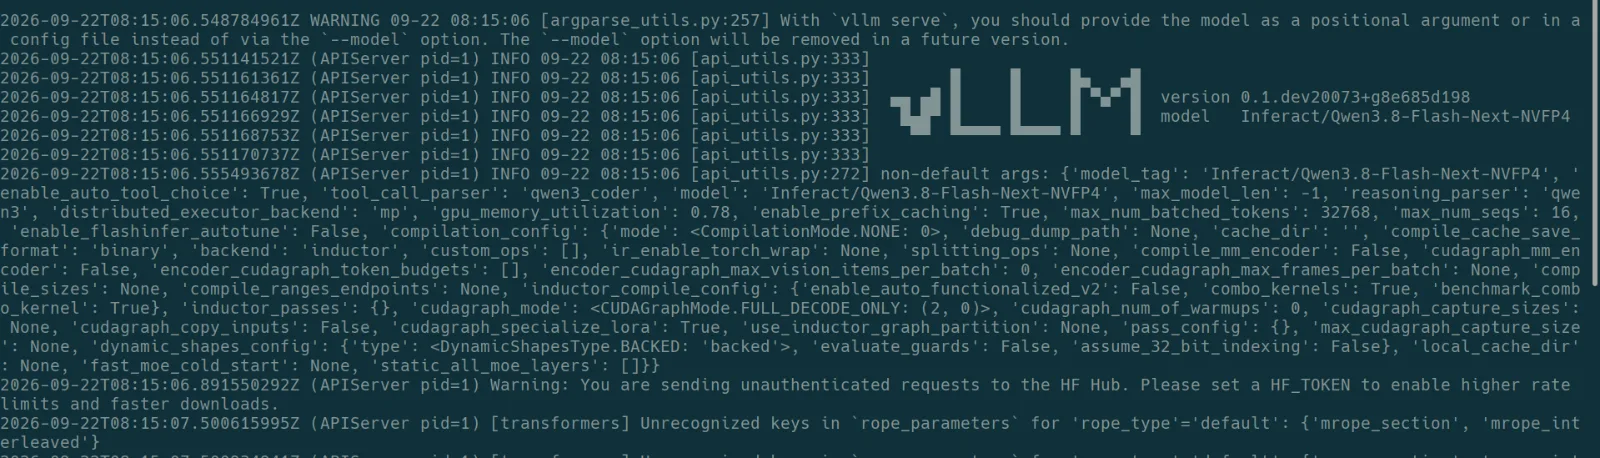
- ตรวจสอบว่าตอนนี้ vLLM ที่รัน QWEN ทำงานรึยัง
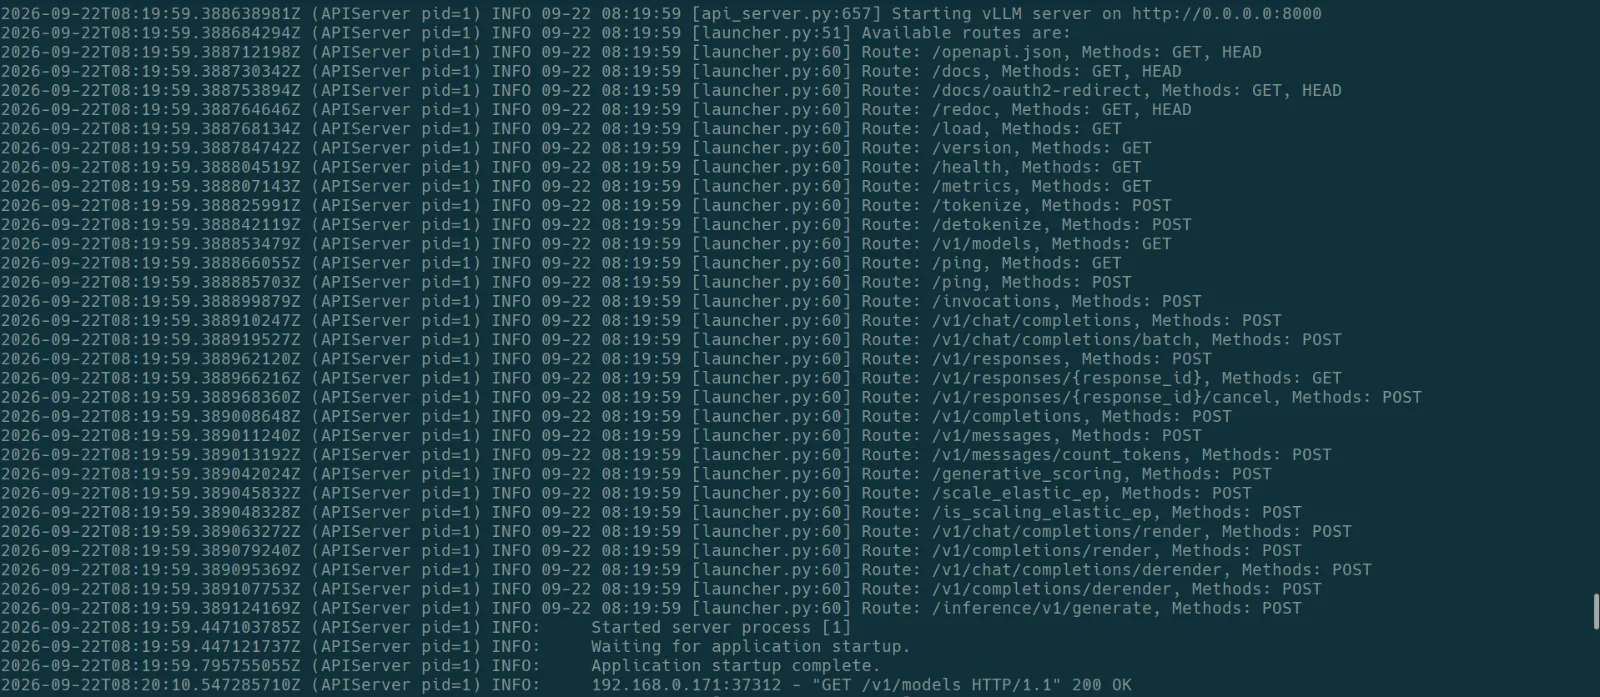
สามารถดูได้จาก Log ดังรูปว่าตอนนี้เซิฟเวอร์ทำงานที่ http://0.0.0.0:8000 แล้วแสดงว่าเซิฟเวอร์ vLLM ของเราพร้อมให้ชำแหละแล้วนั้นเอง หรือทำการทดลองยิงด้วย CURL เข้าไปได้ (บนเครื่อง Host)
# 3.1 CURL สำหรับทดสอบ

curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Inferact/Qwen3.8-Flash-Next-NVFP4",
    "messages": [{"role": "user", "content": "Hello"}],
    "max_tokens": 32
  }'
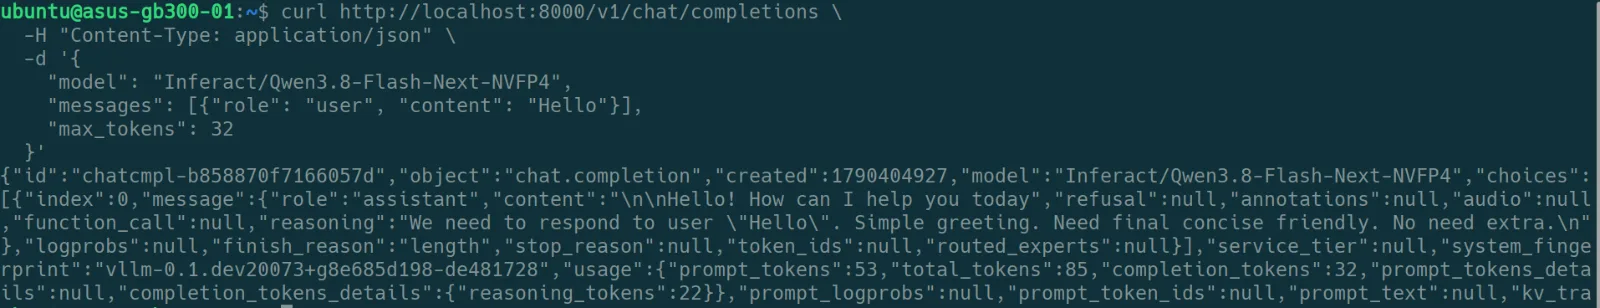
ได้ผลลัพธ์กลับมาว่า "Hello! How can I help you today?" และ LLM ตอบกลับมาได้ตามความคาดหวังก็ใจฟูละครับ
- ทดสอบ Bench Load Balance (ตัวอย่าง)
ในเมื่อเราสามารถ Host LLM ได้แล้วสิ่งที่เราต้องดูก็คือ มันสามารถนำไปใช้งานได้จริงใช้ไหมกับ Work-Load ที่จะเจอในสถานการณ์จริง เพราะคงเกิดคำถามกับผู้ใช้งานว่า มันตอบดีไหม ตอบได้เร็วไหม และสามารถใช้งานได้พร้อมกันกี่ Requests แน่นอนว่า vLLM เขาคิดเรื่องนี้มาให้แล้วแต่เราก็ได้แค่ดูคร่าว ๆ นะครับ- Generate Token/Sec
- Generate Token/Req
- KV Cache Usage (ยังไม่พูดถึงในโพสต์นี้นะครับ) (^^) ปาดเหงื่อ ~
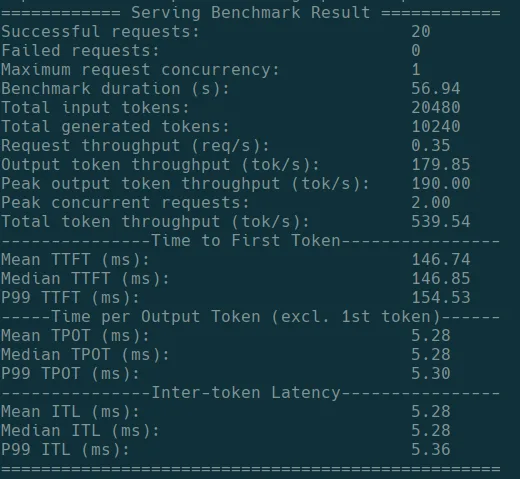
# ทดสอบ Inference โดยใช้ข้อมูลสุ่ม โดยกำหนดให้ Input/Output ไม่เกิน Context Window ที่กำหนดไว้ซึ่งกำหนดไว้ 20 งานให้ยิงทดสอบทีละงาน (ชุดตัวแปรนี้เหมาะสำหรับตรวจสอบว่าต่อ 1 คนใช้งานได้ดีแค่ไหน)

$ docker exec -it vllm-qwen-nvfp4 vllm bench serve \
  --model Inferact/Qwen3.8-Flash-Next-NVFP4 \
  --host 127.0.0.1 \
  --port 8000 \
  --dataset-name random \
  --random-input-len 1024 \
  --random-output-len 512 \
  --num-prompts 20 \
  --max-concurrency 1
ผลลัพธ์จากการ Benchmark แบบเล็ก ๆ
============ Serving Benchmark Result ============
Successful requests:                     20
Failed requests:                         0
Maximum request concurrency:             1
Benchmark duration (s):                  56.94
Total input tokens:                      20480
Total generated tokens:                  10240
Request throughput (req/s):              0.35
Output token throughput (tok/s):         179.85
Peak output token throughput (tok/s):    190.00
Peak concurrent requests:                2.00
Total token throughput (tok/s):          539.54
---------------Time to First Token----------------
Mean TTFT (ms):                          146.74
Median TTFT (ms):                        146.85
P99 TTFT (ms):                           154.53
-----Time per Output Token (excl. 1st token)------
Mean TPOT (ms):                          5.28
Median TPOT (ms):                        5.28
P99 TPOT (ms):                           5.30
---------------Inter-token Latency----------------
Mean ITL (ms):                           5.28
Median ITL (ms):                         5.28
P99 ITL (ms):                            5.36
==================================================
สิ่งนี้บอกอะไรเราบ้าง แบบคร่าว ๆ
- ความเร็วของ OUTPUT ของระบบอยู่ที่ ~179.85 tokens/s
- เวลาในการ PREFILL 1 TOKEN (เวลารอตั้งแต่ส่ง Request จนตัวอักษรแรกปรากฏ) อยู่ที่ 146.74 ms
- การพิมพ์สม่ำเสมอ ไม่มีกระตุก (P99 ITL 5.28 ms): ค่าความล่าช้าระหว่างคำ เช่น " Hello! -> How -> can " ถ้าผมเข้าใจไม่ผิดนะ
คำศัพท์ที่ควรรู้จาก Command
ตาราง: ตัวแปรที่ใช้รัน vLLM
| ตัวแปร | ชื่อภาษาไทย | ประเภทข้อมูล | ความหมาย |
-d | รันเบื้องหลัง | Flag | สั่งให้ Container ทำงานแบบ Background ไม่ล็อกหน้าจอ Terminal |
--name | ชื่อคอนเทนเนอร์ | String | กำหนดชื่ออ้างอิงให้ Container (vllm-qwen-nvfp4) |
--gpus | จัดสรรการ์ดจอ | String | อนุญาตให้ Container เข้าถึงการ์ดจอทั้งหมดในเครื่อง |
--privileged | สิทธิ์ระดับสูง | Flag | ให้สิทธิ์เข้าถึงฮาร์ดแวร์โดยตรงเพื่อความเสถียรของไดรเวอร์ |
--ipc=host | แชร์หน่วยความจำ IPC | String | แชร์ Inter-Process Communication กับโฮสต์ ป้องกันแรมแชร์เต็ม |
-p | แมปพอร์ต | String | เปิดพอร์ต 8000 จาก Container ออกสู่เครื่องหลักเพื่อยิง API |
-e VLLM_USE_V1=0 | ปิดเอนจิน V1 | Environment | บังคับถอยไปใช้ vLLM V0 ที่เสถียรกว่า ป้องกัน Error โมเดลใหม่ |
-v | เมานต์โฟลเดอร์ | String | เชื่อมโฟลเดอร์เก็บโมเดล เพื่อไม่ต้องดาวน์โหลดน้ำหนักใหม่ซ้ำ |
vllm/vllm-openai:... | อิมเมจ Docker | Image tag | ระบุ Docker Image ของ vLLM ที่จะนำมาใช้งาน |
Inferact/Qwen... | ชื่อโมเดล | Model ID | กำหนดโฟลเดอร์หรือ Hugging Face ID ของโมเดลที่จะโหลด |
--tensor-parallel-size | ขนานโมเดลข้ามการ์ด | Integer | จำนวนการ์ดจอที่จะแบ่งชิ้นส่วนโมเดลไปรัน (1 ใบ = 1) |
--gpu-memory-utilization | สัดส่วนจอง VRAM | Float | จอง VRAM ล่วงหน้า 85% สำหรับ Model Weight และ KV Cache |
--max-num-seqs | จำนวนคำขอพร้อมกันสูงสุด | Integer | จำกัดการประมวลผลคำขอพร้อมกันสูงสุดใน 1 Batch ไว้ที่ 64 คิว |
--enforce-eager | บังคับโหมดรันตรง | Flag | สั่งรันคำนวณทีละคำสั่ง ปิด CUDA Graph เลี่ยงการแครชบนชิปใหม่ |
--no-enable-flashinfer-autotune | ปิดจูนเคอร์เนลอัตโนมัติ | Flag | ข้ามขั้นตอนวัดความเร็ว FlashInfer ตอนบูต ช่วยให้เซิร์ฟเวอร์เปิดเร็ว |
--enable-auto-tool-choice | เปิดเลือกระบบ Function Call | Flag | อนุญาตให้โมเดลตัดสินใจเรียกใช้ Tool/Function ให้อัตโนมัติ |
--tool-call-parser | ตัวแปลงคำสั่ง Tool | String | กำหนด Parser เฉพาะทางสำหรับจัดฟอร์แมต Tool Call ของ Qwen |
ตาราง: ตัวแปรที่ใช้ทดสอบ vLLM
| ตัวแปร | ชื่อภาษาไทย | ประเภทข้อมูล | ความหมาย |
exec -it | เข้าไปรันในคอนเทนเนอร์ | Flag | สั่งให้คำสั่งทำงานภายใน Container ที่กำลังรันอยู่แบบโต้ตอบ |
vllm bench serve | คำสั่งเริ่มเบนช์มาร์ก | Subcommand | เรียกโมดูลยิงทดสอบโหลด HTTP API ของ vLLM |
--model | ชื่อโมเดลที่ทดสอบ | String | ระบุชื่อโมเดลใน Payload ให้ตรงกับตัวที่เซิร์ฟเวอร์เปิดรันไว้ |
--host | ไอพีเซิร์ฟเวอร์ | String | กำหนดปลายทางที่จะยิงคำขอทดสอบไป (127.0.0.1) |
--port | พอร์ตเซิร์ฟเวอร์ | Integer | กำหนดพอร์ตเป้าหมายที่เซิร์ฟเวอร์เปิดให้บริการ (8000) |
--dataset-name | รูปแบบชุดข้อมูล | String | ใช้โหมดสุ่มสร้างข้อความขึ้นมาเอง (random) ไม่โหลดไฟล์จริง |
--random-input-len | ความยาวข้อความขาเข้า | Integer | กำหนดขนาด Prompt ทดสอบที่ 1,024 โทเค็นต่อคำขอ |
--random-output-len | ความยาวข้อความขาออก | Integer | บังคับให้โมเดลตอบกลับขนาดยาว 512 โทเค็นต่อคำขอ |
--num-prompts | จำนวนคำขอรวมทั้งหมด | Integer | ส่งคำขอไปทดสอบจนครบตามจำนวน 20 ครั้งแล้วตัดผลสรุป |
--max-concurrency | จำนวนคำขอพร้อมกัน | Integer | กำหนดให้ยิงทีละ 1 คำขอพร้อมกัน (วัด Single-stream Latency) |